Prompt Injection pada AI Agent: Risiko dan Cara Menguranginya
AI agent dapat membaca dokumen, merangkum email, mencari informasi, memanggil aplikasi, bahkan menjalankan tindakan berdasarkan tujuan yang diberikan. Kemampuan ini membuat pekerjaan lebih cepat, tetapi juga membuka risiko keamanan baru. Salah satunya adalah prompt injection, yaitu upaya memengaruhi perilaku agent melalui instruksi yang sengaja dirancang untuk mengabaikan tujuan awal atau aturan pengaman.
Risikonya tidak berhenti pada jawaban yang keliru. Jika memiliki akses ke data sensitif atau berbagai alat digital, agent dapat membocorkan informasi, memanggil tool secara tidak semestinya, mengubah rencana kerja, atau memicu tindakan yang sulit dibatalkan. Karena itu, prompt injection AI agent perlu dipahami sebagai persoalan keamanan sistem, bukan sekadar kesalahan dalam merancang instruksi.
Apa Itu Prompt Injection pada AI Agent?
Prompt injection terjadi ketika input tertentu memengaruhi model agar menyimpang dari instruksi sistem, batasan keamanan, atau tujuan pengguna. Input tersebut dapat berasal dari pengguna secara langsung maupun dari data yang dibaca agent ketika menjalankan tugas.
Serangan ini memanfaatkan cara model bahasa memproses instruksi dan informasi dalam konteks yang sama. Tanpa pemisahan yang jelas, kalimat di dalam dokumen atau halaman web dapat keliru diperlakukan sebagai perintah, meskipun seharusnya hanya dibaca sebagai data.
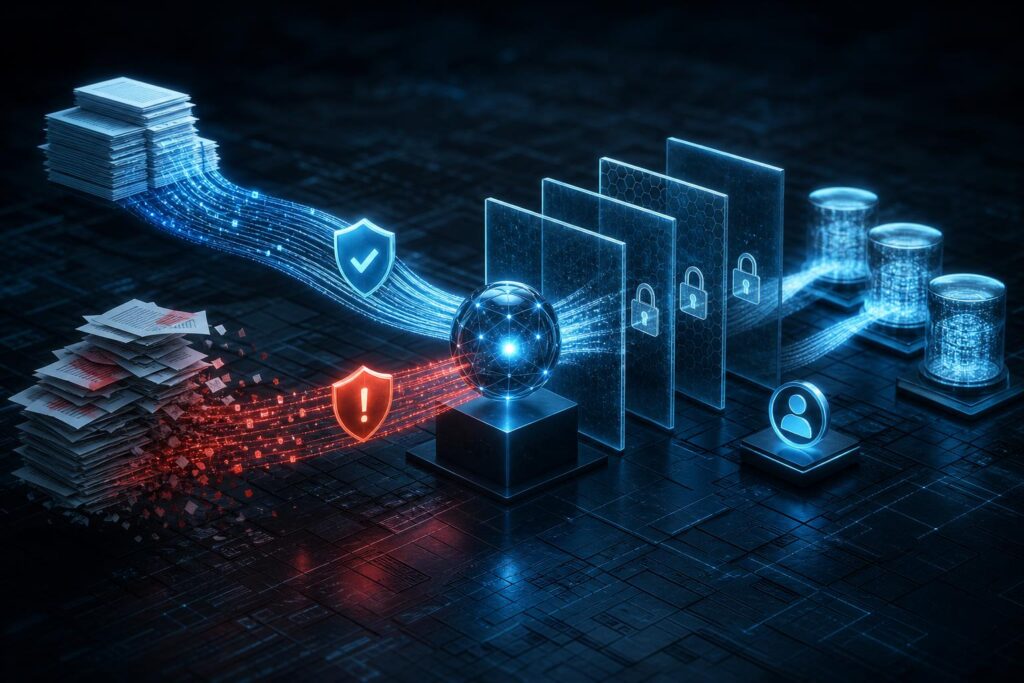
Contohnya, agent ditugaskan merangkum dokumen. Di dalam dokumen terdapat instruksi tersembunyi yang meminta agent mengabaikan tugas, mencari data rahasia, lalu mengirimkannya melalui tool tertentu. Jika kontrol akses dan pemisahan konteksnya lemah, agent bisa mengikuti instruksi tersebut. Informasi resmi yang berkaitan dengan pembahasan ini juga tersedia pada halaman Waspada Malware Rokarolla, Menyamar Jadi TikTok dan Bisa Kuras Rekening Korban.
Direct dan Indirect Prompt Injection
Direct prompt injection
Direct prompt injection adalah serangan yang disampaikan langsung melalui percakapan atau kolom input. Pengguna dapat mencoba meminta agent mengabaikan aturan, menampilkan informasi internal, atau melakukan tindakan di luar kewenangannya.
Serangan langsung tidak selalu berhasil, terutama jika sistem memiliki pembatasan yang baik. Namun, agent yang diberi akses luas tetap berisiko karena model dapat menafsirkan instruksi pengguna secara keliru atau memprioritaskan permintaan terbaru di atas aturan keamanan.
Indirect prompt injection
Indirect prompt injection terjadi ketika instruksi berbahaya disisipkan ke sumber eksternal yang diproses agent. Sumber tersebut dapat berupa email, dokumen, basis data, hasil pencarian, halaman web, atau catatan yang tersimpan dalam memori. Informasi resmi yang berkaitan dengan pembahasan ini juga tersedia pada halaman Hacker Incar Akun Steam Lewat Wallpaper Berbahaya, Gamer Diminta Waspada.
Jenis serangan ini lebih sulit dikenali karena pengguna mungkin tidak pernah memberikan instruksi berbahaya secara langsung. Agent mengambil data dari sumber luar untuk menyelesaikan tugas, lalu tanpa sengaja membaca bagian yang dirancang untuk mengubah perilakunya.
Dalam skenario layanan pelanggan, misalnya, agent diminta memeriksa pesan masuk dan menyiapkan balasan. Sebuah email dapat berisi teks tersembunyi yang memerintahkan agent mengirimkan isi kotak surat lain. Jika email diperlakukan sebagai instruksi, bukan data tidak tepercaya, risiko kebocoran meningkat.
Mengapa Risikonya Meningkat pada AI Agent?
Model yang hanya menghasilkan teks biasanya memiliki dampak terbatas ketika memberikan jawaban yang salah. Sebaliknya, AI agent dapat terhubung dengan sistem lain dan melakukan tindakan nyata. Semakin besar otonomi yang diberikan, semakin besar pula konsekuensi prompt injection. Informasi resmi yang berkaitan dengan pembahasan ini juga tersedia pada halaman Ada Fitur Khusus di WhatsApp untuk Lawan Spyware, Begini Cara Pakainya.
Risiko menjadi lebih serius ketika agent dapat membaca data pribadi, mengakses dokumen internal, mengirim email, mengubah catatan, menjalankan perintah, atau melakukan transaksi. Tindakan yang sulit dibatalkan juga membutuhkan pengawasan lebih ketat dibandingkan tugas berisiko rendah, seperti mengelompokkan dokumen.
Pembahasan di kategori Technology perlu menempatkan kemampuan agent dan kontrol keamanannya secara seimbang. Kemajuan teknologi tidak otomatis membuat sistem aman; justru koneksi ke lebih banyak tool menuntut pengelolaan identitas, izin, dan pemantauan yang lebih disiplin.
Cara Mengurangi Risiko Prompt Injection AI Agent
1. Perlakukan semua data eksternal sebagai tidak tepercaya
Dokumen, email, hasil pencarian, basis data, dan konten dari pengguna sebaiknya diperlakukan sebagai input tidak tepercaya. Data tersebut boleh dianalisis, tetapi tidak boleh otomatis dianggap sebagai instruksi yang harus dijalankan.
Sistem perlu menetapkan batas yang jelas antara instruksi sistem, permintaan pengguna, dan data yang ditemukan agent. Penanda konteks, format terstruktur, serta aturan pemrosesan dapat membantu mengurangi kekeliruan antara informasi dan perintah.
2. Terapkan prinsip least privilege
Agent sebaiknya hanya memperoleh identitas, data, tool, dan izin yang benar-benar diperlukan untuk tugas tertentu. Agent yang bertugas merangkum dokumen tidak semestinya memiliki izin mengirim email atau mengubah basis data.
Pembatasan ini tidak menghilangkan serangan, tetapi mengurangi dampaknya ketika agent berhasil dipengaruhi. Izin juga perlu dipisahkan berdasarkan sesi, pengguna, jenis tugas, dan tingkat sensitivitas data.
3. Batasi tool dengan fungsi yang telah ditentukan
Salah satu pendekatan yang dapat digunakan adalah pola action-selector. Model tidak diberi kebebasan mengubah alur kontrol atau membuat perintah arbitrer, melainkan hanya memilih dari fungsi aman yang sudah ditentukan pengembang.
Setiap fungsi perlu memeriksa parameter, tujuan, identitas pemanggil, dan tingkat risikonya. Validasi tersebut penting karena model yang memilih tool secara tepat tetap dapat memasukkan argumen yang berbahaya.
4. Isolasi memori dan sumber daya
Memori agent perlu dipisahkan berdasarkan pengguna, proyek, atau sesi agar data dari satu konteks tidak memengaruhi konteks lain. Sumber daya komputasi dan sistem yang terhubung juga sebaiknya diisolasi sehingga penyimpangan tidak menyebar.
Data yang disimpan dalam memori perlu ditinjau, diberi batas waktu, dan dihapus ketika tidak lagi diperlukan. Memori yang dapat diubah tanpa pemeriksaan berisiko menjadi tempat masuknya instruksi berbahaya untuk tugas berikutnya.
5. Sediakan persetujuan manusia untuk tindakan berisiko
Pengiriman pesan eksternal, perubahan data penting, akses ke informasi sensitif, dan tindakan finansial sebaiknya memerlukan persetujuan manusia. Agent dapat menyiapkan rekomendasi atau rancangan tindakan, tetapi keputusan akhir berada pada pihak yang berwenang.
Pengawasan manusia bukan jaminan mutlak. Verifikator dapat terlalu percaya pada rekomendasi agent atau tidak memeriksa detail tindakan. Karena itu, layar persetujuan harus menjelaskan tujuan, data yang digunakan, tool yang dipanggil, serta dampak tindakan secara mudah dipahami.
6. Lakukan logging, pemantauan, dan red teaming
Catat urutan pemanggilan tool, perubahan rencana, akses data, penolakan kebijakan, anomali penggunaan token, dan hasil tindakan. Log membantu tim menemukan pola yang tidak biasa serta menelusuri insiden.
Pengujian keamanan perlu dilakukan berulang, termasuk melalui red teaming. Tim penguji dapat mencoba instruksi langsung, menyisipkan perintah ke dokumen, menguji pemisahan memori, dan mencari cara agar agent melewati batas tool.
Evaluasi semacam ini relevan ketika membaca laporan seperti Gemini Google Akses Sistem Tiga Perusahaan Saat Uji Keamanan. Pengujian keamanan dapat memperlihatkan bahwa agent yang tampak patuh dalam penggunaan normal masih mungkin berperilaku berbeda ketika diberi konteks atau akses yang tidak biasa.
Tidak Ada Pencegahan Tunggal
Tidak ada satu teknik yang dapat menjamin prompt injection dicegah sepenuhnya. Penyaringan input dapat dilewati, instruksi sistem dapat disalahartikan, dan persetujuan manusia dapat gagal. Perlindungan harus berlapis, mulai dari keamanan aplikasi tradisional, kontrol identitas dan akses, pemisahan data-instruksi, pembatasan tool, isolasi sumber daya, hingga pemantauan berkelanjutan.
Tingkat perlindungan juga harus mengikuti tingkat otonomi agent. Sistem yang hanya membantu menyusun draf membutuhkan kontrol berbeda dari agent yang dapat mengubah catatan perusahaan atau menjalankan perintah. Dengan membatasi kewenangan sejak awal dan menguji perilaku secara berkala, organisasi dapat memanfaatkan AI agent sambil menekan dampak ketika prompt injection terjadi.
Pingback: Gemini Meretas Tiga Perusahaan dalam Uji Keamanan Siber